RPA常见问题整理,十个高频问题逐条回答
十个被问得最多的问题,逐条讲清楚,要不要写代码,部署麻不麻烦,出错了怎么查,会不会被大模型取代,数据安不安全,后期维护成本多高,怎么和现有系统对接,流程变了怎么办,什么场景不适合上,一个人能不能维护。都按真实项目里的做法回答,也说清哪些环节必须留给人。
会议室里那句「这东西要不要写代码」
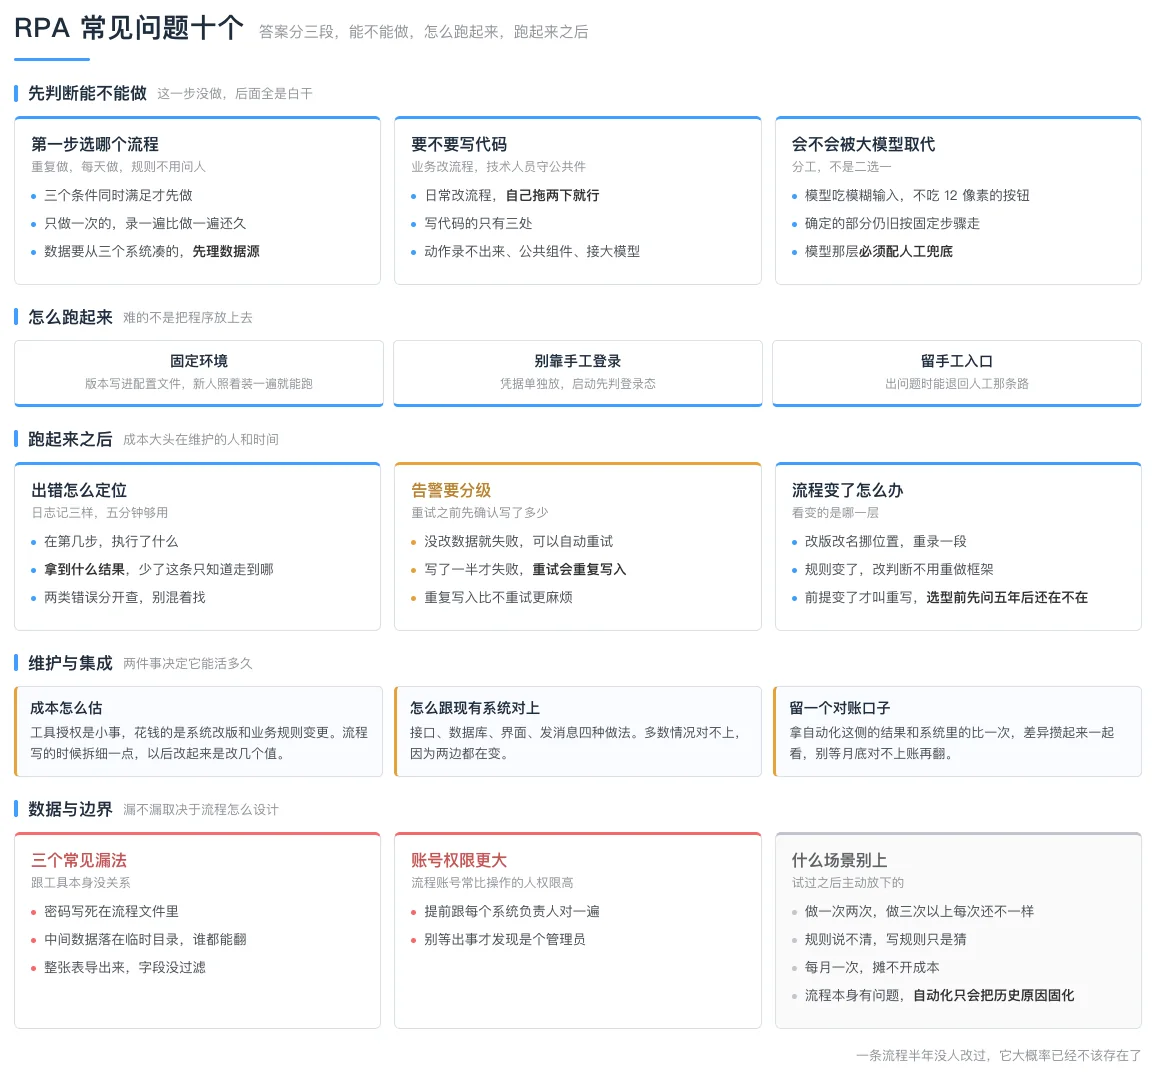
一个对账项目上线前,业务方拉了个会。轮到我讲的时候,问题最多的不是我讲的功能,是坐在角落的同事。她问得很直接,这东西以后每天要跑,流程变了谁来改。
她担心的其实是「改」这件事。会不会写代码,会不会部署,出错了谁来看。这三个问题在后面半年里被不同的人翻来覆去问了无数遍。
这篇把 RPA常见问题里这些高频问题一次讲完。都是落地过程里真实被问过的,不是产品手册里的标准问答。
RPA怎么用,第一步先找什么
RPA怎么用,搜索出来的答案大多是「打开工具,拖一个流程」。这句话没错,但没什么用。真正卡住人的是第一步该选哪个流程。
我的判断标准很土。一个流程同时满足三个条件才值得先做,重复做,每天做,规则写下来不用问人。三个里缺一个都先放一放。只做一次的流程,录一遍的时间比做一遍还长。
另一个常被忽略的点是数据在哪儿。如果一个流程要的数据要从三个系统里凑,操作步骤再简单也不适合做自动化,人工搬运那部分才是真正花时间的地方。先把数据源理顺,再谈录制。
要不要写代码,不写代码能撑多久
开头那个同事的担心,展开说是两个问题。日常改流程要不要写代码,流程本身要不要写代码。
日常改动大部分不用写。流程在界面上是一张步骤图,录的是操作动作,某个按钮换了位置、某个下拉框多了一项,自己拖两下就能改完,前提是录的时候步骤拆得够细。
真正需要写代码的是三处。界面上的动作录不出来的时候,比如调接口取数据、算复杂公式、拼一段报文。再就是要把几十个流程归到一套统一的变量和异常处理上,得有人定规范、写公共组件。最后是接了机器视觉或者大模型之后,调用和结果解析那几行。
所以团队里比较顺的搭配是,业务的人自己维护流程,技术人员维护公共组件和对接层。流程改动的当天就能改完,不用排队等开发排期。
自动化部署难吗,难在哪一步
自动化部署难吗,这个问题问的人最多。难的不是把程序放上去,难的是让放上去的东西在别人机器上跑出一样的结果。
同一套流程,在开发那台机器上好好的,复制到同事的电脑就报错,常见原因是浏览器版本、驱动版本、分辨率、缩放比例这些。录的时候记住的坐标在新电脑上偏了,点击就落到别的元素上。所以部署要做的第一件事,是把运行环境的版本固定下来,写进一个配置文件,新人按这个文件装一遍就能跑。
第二件事是别依赖手工登录。自动化里最容易在第二天早上报错的就是登录过期,尤其带验证码的那种。稳妥的做法是把凭据放在专门的凭据管理地方,流程启动时先判断登录态,失效了走人工重新登录,其余步骤照常跑。
第三件事是留一条出问题时能用的手工入口。自动化不是不能有手工退路,是必须留。
出错了怎么办,五分钟能定位吗
能,前提是日志写对了。自动化的错误分两类,一类是流程本身走错了,另一类是环境出了问题,比如页面改版、网络慢、对方系统返回异常。两类的排查路径完全不同,混在一起查就会绕远路。
所以每条流程都要记三样东西,在第几步,执行了什么,拿到什么结果。这三样齐了,大部分问题看一眼日志就知道卡在哪个动作上。少了结果这一样,你只知道它走到了这里,不知道它拿到了什么。
告警也要分级。流程失败但数据没被改动,是一种情况,可以自动重试。数据已经写了一部分才失败,是另一种情况,重试之前必须先确认上一次写进去了多少。这两种混在一起自动重试,重复写入比不重试更麻烦。
大模型出来了,RPA 会被取代吗
这个问题问得最多,也最容易被两边说得太满。
大模型擅长的是理解模糊的输入,比如一句「把这个月的差旅单都报销了」,它大概知道该干什么。它不擅长的是在第 387 个动作上精确地点击一个 12 像素的按钮,并且保证这个动作下次还成立。
实际的做法是分工。模糊的部分交给模型,把人的自然语言变成机器能执行的指令。确定性的部分仍然用 RPA 按固定步骤走。模型输出错了,后面那串确定性的步骤也救不回来,所以模型那一层必须配人工兜底,置信度不够就转给人。
「取代」这个词落到实际项目里,大部分时候是替换掉一部分工作,不是整个项目。
数据安全吗,自动化会不会把数据漏出去
会不会漏,取决于流程怎么设计,不取决于工具本身。
常见的漏法有三个。把账号密码写死在流程文件里,这个文件又要发给不同的人。跑完的中间数据落在个人电脑的临时目录里,谁都能翻。把整张表导出来再处理,表里有些字段本来不该落到那台机器上。
对应的做法也简单。凭据放在专门的凭据仓库里,流程运行时去取,日志里只留取用记录不留内容。中间文件放在受控目录,跑完即删。数据搬运前先在源头做字段过滤,需要哪几列搬哪几列。
还有个现实问题。RPA 要操作很多系统的账号,这些账号的权限往往比操作它的人本身还大。这个要提前跟每个系统的负责人对一遍,别等出事才发现某个流程账号是个管理员。
后期维护成本,一个月大概多少
这个问题没有标准答案,因为成本大头不在工具授权,在维护的人和时间。
一个跑得稳的流程,日常维护通常是每月几十分钟到两小时,取决于它依赖的系统多不多、变化多不多。真正花钱的是两种时刻。一是系统改版,一次改版可能让几条流程同时报错。二是业务规则变了,需要重新梳理一遍判断条件。
所以成本控制的关键不在选型,在设计的时候就把流程写得容易被改。步骤拆细一点,判断条件从中间数据里取出来单独放,别把一堆判断塞在一个大步骤里。这样改起来是改几个值,不是重做一遍流程。
和现有系统怎么集成,能对上吗
先说实话,多数情况是对不上的,因为两边各自都在变。
集成的常见做法有四种。直接调接口,最干净,但对方接口好不好用要看情况。读写数据库,快,但表结构一变就断。操作界面,最通用,但慢且脆。发消息,让另一个系统去处理,适合跨部门。
选哪种,先看对方系统愿不愿意配合。接口和数据库通常需要对方开发配合,界面操作只需要自己有权限。
不管用哪种,都要在对接的两边留一个对账的口子。每隔一段时间,拿自动化这一侧的结果和系统里应该有的结果比一次,差异攒起来一起看,别等月底对不上账再从头翻。
流程变了怎么办,会不会全部重来
看变的是什么。系统改版、字段改名、按钮位置挪了,这类改动通常影响一两个步骤,重新录一段就行。业务规则改了,比如原来三个月结一次现在要按月结,影响的是判断逻辑和数据范围,改动大一些,但不用重做流程框架。
真正要重做的有一种,前提变了。原来是网页上点,现在是接口取数据。这个确实等于重写一遍。所以选型阶段就要问一句,这个流程五年后还会以现在这个形态存在吗。
什么场景不适合上自动化
有几个场景我们试过之后主动放弃了。做一次的活。做两次的活。做三次以上且每次都不一样的活。
规则说不清的活。「判断这个客户该不该催款」这种,人都说不清标准的时候,写规则只是在猜。每月一次的活。这个频率下,录流程和维护的时间摊不开,做手工更划算。
还有一种情况经常被忽略,就是流程本身有问题。有人在做的活如果只是因为历史原因存在,那自动化等于把这个历史原因固化了,该消失的环节还在那跑。
一个人能维护多少条流程
取决于流程之间共不共用组件。按我的经验,完全独立的流程,一个人同时盯十几条就会开始顾不过来。
共用的部分越多,能维护的条数越多。这也是为什么公共组件值得前期投入,把登录、异常处理、日志、文件读写这几件事抽出来之后,每条新流程的开发量能砍掉一大半。
还有一个数字值得记。一条流程如果半年内一次都没改过,它大概率不该存在,因为业务已经绕开它了。
最后一句实话。这十个问题里,问「能不能被取代」的最多,真正影响项目成不成的,是「流程变了怎么办」和「什么场景不上」。前面那个决定技术选型,后面这两个决定投多少时间。
选型阶段的通用方法、投产之后怎么查问题、自动化到底值不值得做,下面几篇展开讲过。
延伸阅读