招聘简历初筛,解析、打分与候选人同步的一条流水线
简历初筛的活儿里,能被机器接走的只有两段,一段是把关键字段从几十页文档里抽出来并归一,另一段是把结论写回 ATS 系统。中间那段判断该留给人。招聘简历自动筛选的难点在边界划清楚,哪些条件能做规则,哪些字段不该入库。这篇按解析、硬条件过滤、打分排序、同步回写、合规红线五段讲,附异常处理和人工介入点,也说清何时不值得上。
一封简历投进来,HR 的时间花在哪
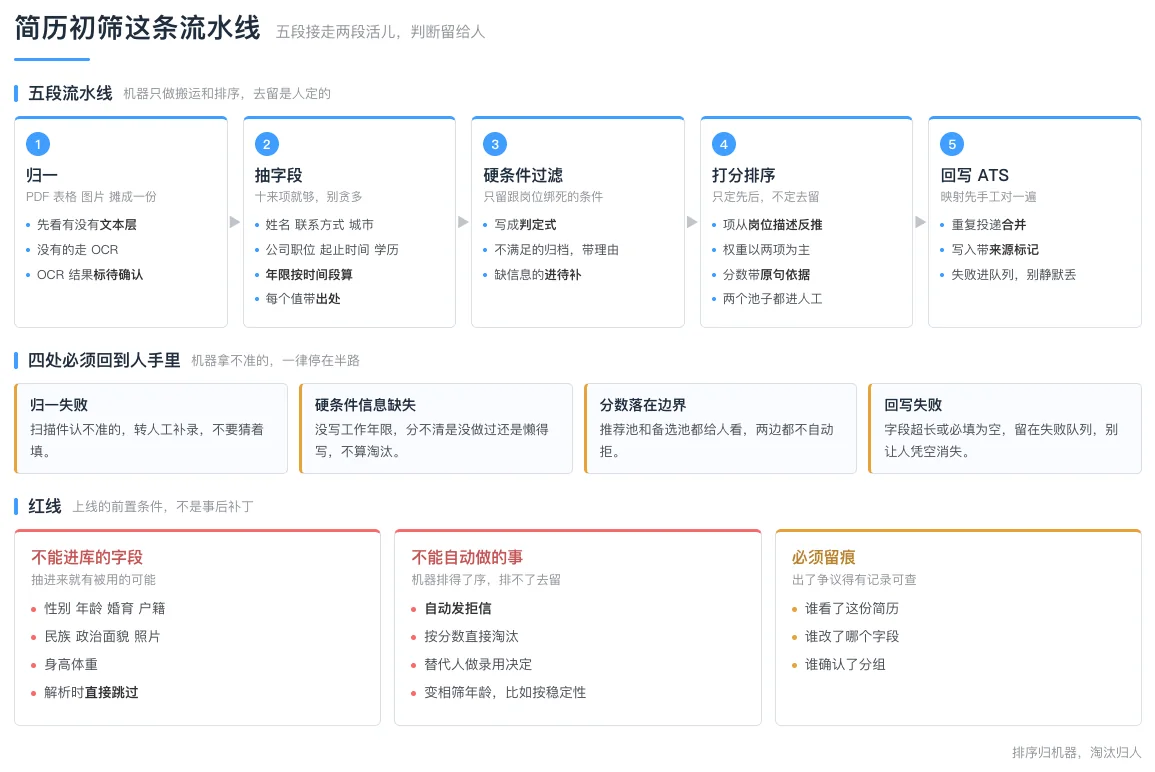
招聘流程自动化这四个字听起来很大,落到具体动作上就三件事。一份份简历打开,看履历,看公司,看年限,判断合不合适,然后把判断敲进系统。整套动作里能被机器接走的只有一部分,剩下的必须由人做。这个分界想不清楚,流程搭出来一定别扭。
从打开招聘后台那一刻说起更具体。岗位挂着,投进来的简历躺在同一个列表里。点开一份,长的要拖好几屏。读的时候做两件事,一是找到需要的那几行,二是判断这几行够不够格。看完之后,结论还得再敲一遍,敲进招聘管理系统对应的那一栏。
这三步的耗时分布很不一样。第一步占的比重不低,靠抽取技术能省掉一部分。第三步几乎不占时间,却经常被漏掉,因为人习惯觉得自己记得住,等到要回看某个候选人当初为什么被推进下一轮,翻半天记录找不到。
中间那步是判断。判断本来就该由人做。所以一套招聘简历自动筛选流程,正确的目标是把第一和第三步接走,让人打开系统看到的就是排好序、带着判断依据的清单,而不是替人决定谁该被拒。
简历解析自动化,难点不在解析,在格式
同一个岗位,简历从不同渠道进来,形态差别很大。招聘网站申请,出来的是结构化表单加一个附件。有的岗位用邮箱收简历,附件是 PDF。有的直接把 Word 文档丢过来。还有的把网站里的简历导成表格,一个候选人一张宽表,列名还各不相同。图片格式的也见过,简历正文本身就是一张图。
归一这一步要做三件事。
先判断手里这份有没有文本层。PDF 有的能直接复制出文字,有的是扫描件或者截图,什么都复制不出来。有文本层的直接取,省一次识别,也少一层错误。没有文本层的才走 OCR,走 OCR 的结果一律标记为待确认,不直接当成事实用。
再把表格型的那类摊平成文档。导出表里一个人一行,字段名写在表头,同一列在不同导出批次里名字可能不一样,日期格式也可能跟着变。摊平的时候保留原始表头,出问题才知道是哪一列映射错了。
最后统一成一份内部格式。这一步不追求好看,追求字段位置固定,后面的抽取规则只需要写一遍,换一批简历不用重写。
归一做完才开始抽字段。字段清单不要贪多,招聘流程自动化里真正被用到的就那么十来项。
姓名、联系方式、当前城市、期望岗位。最近一段经历的公司与职位,每一段经历的起止时间。学历包含学校、层次、专业。工作年限按各段经历的时间算出来,不直接读简历上自己写的那句。技能关键词按行业常见写法归一。
归一这一步的坑集中在同一个地方,同一件事有很多种写法。时间写成 2019.7-2022.3、2019年7月至今、2019 年 7 月至 2022 年 3 月、或者只写 2019 到 2022,都见过。公司名后面挂着有限公司、股份有限公司、集团。学历有大学专科、专科、大专,统招本科、全日制本科、本科。技能有 React 和 React.js 和 ReactJS。归一的时候原值和新值两份都留着,出错能回看是哪一步归错的。
不确定的地方要标出来,不要猜。工作年限按时间段算,算出来的和简历自述对不上,以算出来的为准,同时标一行两者不一致。字段抽不到就空着并且标缺失,不要填零。零会被下游当成确实没有,空着才知道要去问。每抽到一个字段都要带出处,标到第几段,HR 点开就能核对,也方便出问题时分清是抽取错了还是原简历写得含糊。
硬性条件过滤,先把不该算的条件剔出去
硬性条件过滤最容易出事,因为条件是从招聘要求里抄来的,抄的时候没人想过滤维度合不合规。
先划一条线。招聘要求里的条件分两类,一类跟岗位本身绑死,比如必须带某个资质证书、必须接受长期出差、必须下个月到岗。另一类跟个人特征绑,比如年龄上限、性别要求、婚育状况。第一类能做机器规则,第二类不能碰,这一节只讲第一类,合规的部分放在后面单独讲。
能碰的条件要写成可判定的规则,并且每条规则都说得出依据在简历哪一行。工作年限不少于三年,判定式是各段经历起止时间求和,然后跟门槛比。学历本科及以上,判定式是学历层次归一之后比大小。
一条写不成判定式的,说明它不硬。沟通能力强写不成判定式,有 B 端销售经验可以写成简历里出现过客户类型加岗位名称的组合。
过滤结果分两档,这一档设计比规则本身更要紧。
明确不满足的,机器可以直接归档,但必须带上理由和依据那一行原文。信息缺失的,进待补队列,不算淘汰。这个区分很要紧。一个人没写工作年限,机器分不清他是没做过还是懒得写,直接按不满足处理,这个错误没法挽回。
还有一个边界。硬条件里混进一条不合规的,整条规则的输出都作废,不能只把那一项单独剔除。规则改了还能重来,一份被筛掉的简历追不回来。
打分模型,先定成排序工具
打分模型是干什么用的,得先定清楚。它的作用是决定谁排在前面被看到,不决定谁被拒掉。定位错了,后面的设计全跑偏,最后做出来的东西 HR 不会用。
打分项从岗位描述反推。岗位描述里写了什么要求,就对应一个打分项,每个打分项都要能指到简历里的某类证据。岗位写了跨境电商运营,打分项就是公司或项目描述里出现过跨境业务、出现过平台名、出现过 Listing 相关描述。指不到证据的项,权重再高也是摆设。
权重别一次调太多。做法是跟用人部门一起,把最重要的两三项排出来定高权重,剩下的给低权重。定完写一句人话解释放在配置旁边。解释不出来说明权重是拍的,用人部门不会认这个分,后面每次调整都要重新吵一遍。
分数要带理由,这是能不能被用起来的分界线。只给一个数字,HR 看不懂也没法向候选人解释。正确的形式是这个人得了哪些分、每一项依据简历里的哪一段原话。点开能看到原句的分数才有人敢用。
阈值别一刀切。设两个线,一个线以上进推荐面试,一个线到第一个线之间进备选池。两个池子都进人工。没有淘汰线,淘汰是人的决定。
两个做法要避开。一是把打分做成一个谁也看不懂的总分排序,二是用分数直接触发拒信。这两种都会让流程停在尴尬位置,人不信分,人又懒得自己重排,最后还是要全部看一遍,等于白做。
打分还有个更省事的用法,分组加排序。组是把人分进推荐、备选、待补三档,帮 HR 减少要逐份看的量。排序是组内排先后,帮 HR 决定先看谁。两个动作在同一份清单上完成,不用拆成两套流程。
同步到 ATS,字段映射先手工对一遍
简历评完了要进系统。招聘流程自动化的最后一段是回写,写不好,前面做得再干净也是白干。
字段分三类处理。第一类直接映射,姓名、手机号、邮箱,简历里写什么就是什么。第二类是标准化后的值,学历归一后的层次、工作年限算出来的数字、当前城市,这些机器算出来的可信度高,可以直接写。第三类是需要人确认的,归一失败的、缺字段的、机器没把握的,这批先进待补队列,不写进 ATS 的正式字段。
映射关系先手工对一遍再开自动。ATS 的字段是固定的,各家叫法不一样,简历上的写法又是另一套。两边对不上的地方写一张对照表存下来,写一次能省掉后面所有排查。对照表要包含字段名、取值格式,还有那个容易错的转换规则。
幂等在这段特别重要。同一个人可能从不同渠道投两次,简历文件可能相同也可能改过。用邮箱加简历内容哈希做键,重复投递合并到同一条记录,不新建。同步本身也要幂等,重推一次不能多出一条记录,不然 HR 那边看下来就是重复候选人。
写进去的字段要带来源标记。每个自动写入的值旁边标一句它来自哪份简历的哪一段。HR 一眼能看出哪些值可信、哪些要再核一眼。没有标记的字段 HR 一律不信,等于白写。
写失败的处理别省。字段超长、格式不匹配、必填项为空,这些写不进去的进失败队列,留原始记录和失败原因,不要静默丢掉。静默丢掉的结果是这个人从流程里消失了,谁也不知道。
还有个顺序问题。先在 ATS 里把需要的字段建好,再接自动化。反过来做,接到一半才发现字段不够用,映射表重做,已经跑过的数据要回填。
合规这件事,边界比技术难
这一段本该放在最前面。放最后是因为人先关心做法,做法讲完再把边界划清楚,比一上来讲红线好记。但真到上线那一刻,红线是前置条件,不是事后补丁。
第一类是不能用于筛选的个人特征。性别、年龄、婚育状况、户籍所在地、民族、政治面貌、照片、身高体重。简历上有的这些字段,解析时主动跳过,不要抽进库里。抽进来就有被用的可能,一旦有人为了凑字段写了条筛选规则,后果很难挽回。
第二类是变相的年龄歧视。用稳定性筛人,比如要求近三年没有跳槽,按年龄推断什么时候会退休,这类规则写下来是中性词,跑出来是年龄歧视。这类规则不容易一眼看出来,但筛掉的结果往往集中在一个年龄段。判断可以朴素一点,看这条规则筛掉的人年龄是不是普遍偏大,是就是在筛年龄。
第三类是机器不能替人做的决定。录用和不录用是人的决定。这条流水线可以给排序,可以给分组,可以把明显不满足硬条件的归档,不能自动发拒信。
拒信这件事多说一句。技术上一条规则就能自动发,很省事,后果也直接。用户收到一封自己不知道为什么被拒的信,出了纠纷连解释的依据都没有。稳妥的做法是淘汰也走人工确认,或者至少留一条申诉通道,让人能问一句为什么。
第四类是留痕。谁看了这份简历,谁改了哪个字段,谁确认了分组,这些要能查。招聘是涉及个人权益的事,出了争议的时候没有记录等于没发生过。
什么情况下别上这套
几种情况,自动化大概率不划算。
岗位本身说不清要求。岗位描述只有几句空话,技能项都定不出来,打分模型无从谈起,先把需求写清楚更实在。
投递量很小。人工看一遍就完事的量,做一套抽取加同步,搭的时间比省下来的多。
每份简历都必须有人看。高级岗和特殊岗位常常是这样,机器排出来的顺序没有意义,筛掉的每一份也都有人单独讨论。这种情况下自动化的价值只剩省掉敲字段那点工夫。
ATS 没人维护。回写要落到一套稳定的字段体系里,字段没人管、必填项老是变,接上去的自动化隔一段时间就要跟着改,改到最后没人愿意管。
最后一句实话。这套流程的成本大头不在工具,在两头。一头是岗位描述写得糊,另一头是字段定完之后没人维护。这两样不解决,工具再顺手也只是把垃圾搬得更快。
字段抽取的坑、打分排序的思路,还有流程出问题怎么定位,下面几篇展开讲过。
延伸阅读